Tối ưu token khi code với Claude Code: hiểu cơ chế cache và 8 cách giảm chi phí
Mỗi lượt hỏi, Claude Code gửi lại toàn bộ hội thoại; khi cache hết hạn, cùng một câu hỏi có thể đắt gấp 25–40 lần. Bài giải thích token đi đâu và 8 cách giữ ngữ cảnh gọn, giữ cache còn hạn, theo tài liệu chính thức của Anthropic.
Mục lục
- Mỗi lượt hỏi gửi lại toàn bộ hội thoại, không chỉ câu mới
- Cache hết hạn là lúc một câu hỏi đắt gấp 25–40 lần
- Cách 1: đo trước khi cắt, bằng /usage và /context
- Cách 2: Sonnet cho phần lớn việc, Opus cho quyết định khó, chọn ngay đầu phiên
- Cách 3: tránh các thao tác làm mất cache giữa phiên
- Cách 4: /clear giữa các việc, /compact ở điểm dừng, /rewind khi sai hướng
- Cách 5: CLAUDE.md và MCP có mặt ở mọi lượt, nên giữ chúng gọn
- Cách 6: lọc output bằng hook trước khi nó vào ngữ cảnh
- Cách 7: việc đọc nhiều thì giao cho subagent, phiên chính chỉ nhận báo cáo
- Cách 8: yêu cầu càng cụ thể, Claude càng ít phải đọc file
- Nói gọn lại: ngữ cảnh nhỏ, cache còn hạn, output đã lọc
Nếu anh em mở /usage sau một buổi làm việc dài với Claude Code, phần lớn token (đơn vị văn bản mà model xử lý và tính phí) thường không nằm ở output. Chúng nằm ở ngữ cảnh (context) được gửi lại ở mỗi lượt hỏi, và phần này có thể đắt gấp 25–40 lần chỉ vì bộ nhớ đệm (prompt cache) vừa hết hạn. Vì vậy, muốn giảm token thì giữ ngữ cảnh gọn và giữ cache còn hạn, không phải bắt Claude trả lời ngắn đi.
Bài này giải thích ngắn cơ chế đó, rồi đi qua 8 cách làm kèm lệnh cụ thể. Các cách này chủ yếu cắt thứ Claude không cần cho việc đang làm: ngữ cảnh của việc cũ, output lệnh dài, lần xử lý lại khi cache hết hạn. Số liệu lấy từ tài liệu chính thức của Claude Code và bảng giá API của Anthropic, đọc ngày 14/10/2026.
Mỗi lượt hỏi gửi lại toàn bộ hội thoại, không chỉ câu mới
Theo tài liệu prompt caching của Claude Code, mỗi lần người dùng gửi tin, Claude Code tạo một request API mới. Model không nhớ gì giữa các request, nên toàn bộ ngữ cảnh được gửi lại, xếp từ ít thay đổi đến hay thay đổi. Thứ tự là system prompt và định nghĩa công cụ, ngữ cảnh dự án (CLAUDE.md, auto memory, rules), hội thoại, rồi tin nhắn mới. Hội thoại gồm cả nội dung file Claude đã đọc và output các lệnh đã chạy, nên dài thêm sau mỗi lượt.
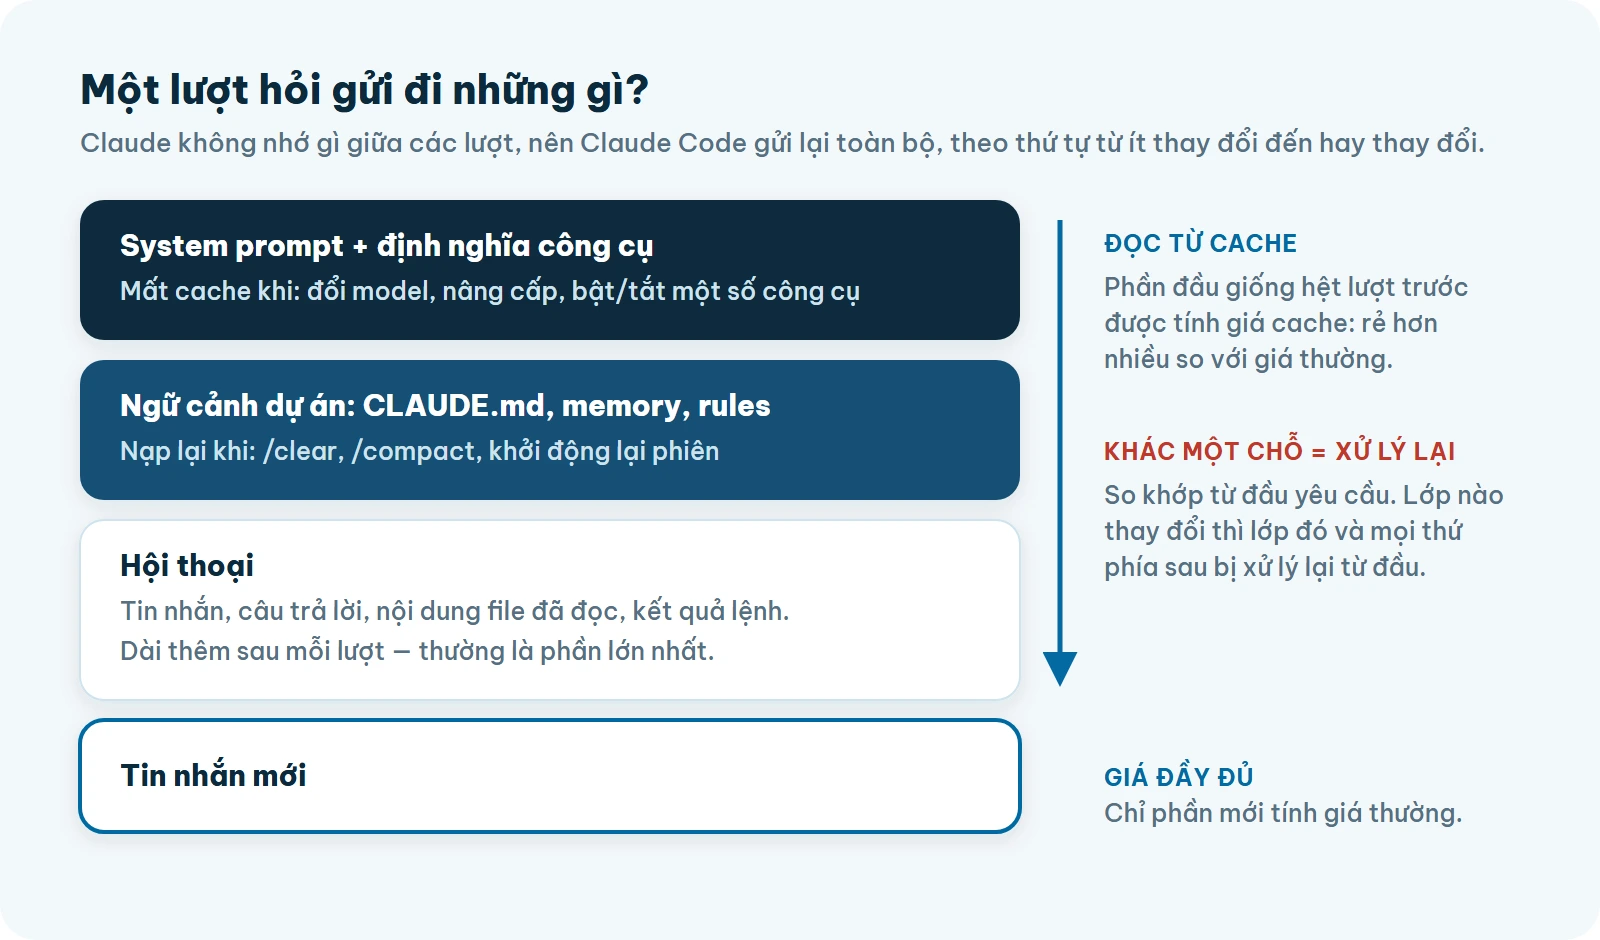
Một câu hỏi cũng không chỉ tạo một request: mỗi lần Claude dùng công cụ lại có thêm một request mang theo kết quả công cụ. Tài liệu chi phí của Claude Code tóm lại là ngữ cảnh càng lớn, mỗi lượt càng tốn. Một câu hỏi một dòng trong phiên mở cả ngày vẫn tính phí cho toàn bộ hội thoại, dù ở mức giá cache.
Suy luận mở rộng (extended thinking, sau đây gọi là thinking) tính như output token, với ngân sách mặc định có thể tới hàng chục nghìn token mỗi request tuỳ model. Opus 5.5, Sonnet 5.5 và Haiku 5.5 luôn dùng thinking; muốn giảm thì hạ mức effort (mức suy luận) bằng /effort hoặc trong /model.
Cache hết hạn là lúc một câu hỏi đắt gấp 25–40 lần
Phần gửi lại không bị tính đủ giá là nhờ prompt cache. API so khớp phần đầu request (prefix) với nội dung vừa xử lý gần đây, và phải khớp chính xác: một chỗ khác thì mọi thứ sau chỗ đó bị tính lại. Không có cache theo từng file. Ở lượt bình thường, prefix là toàn bộ request trước, chỉ phần trao đổi mới là mới.
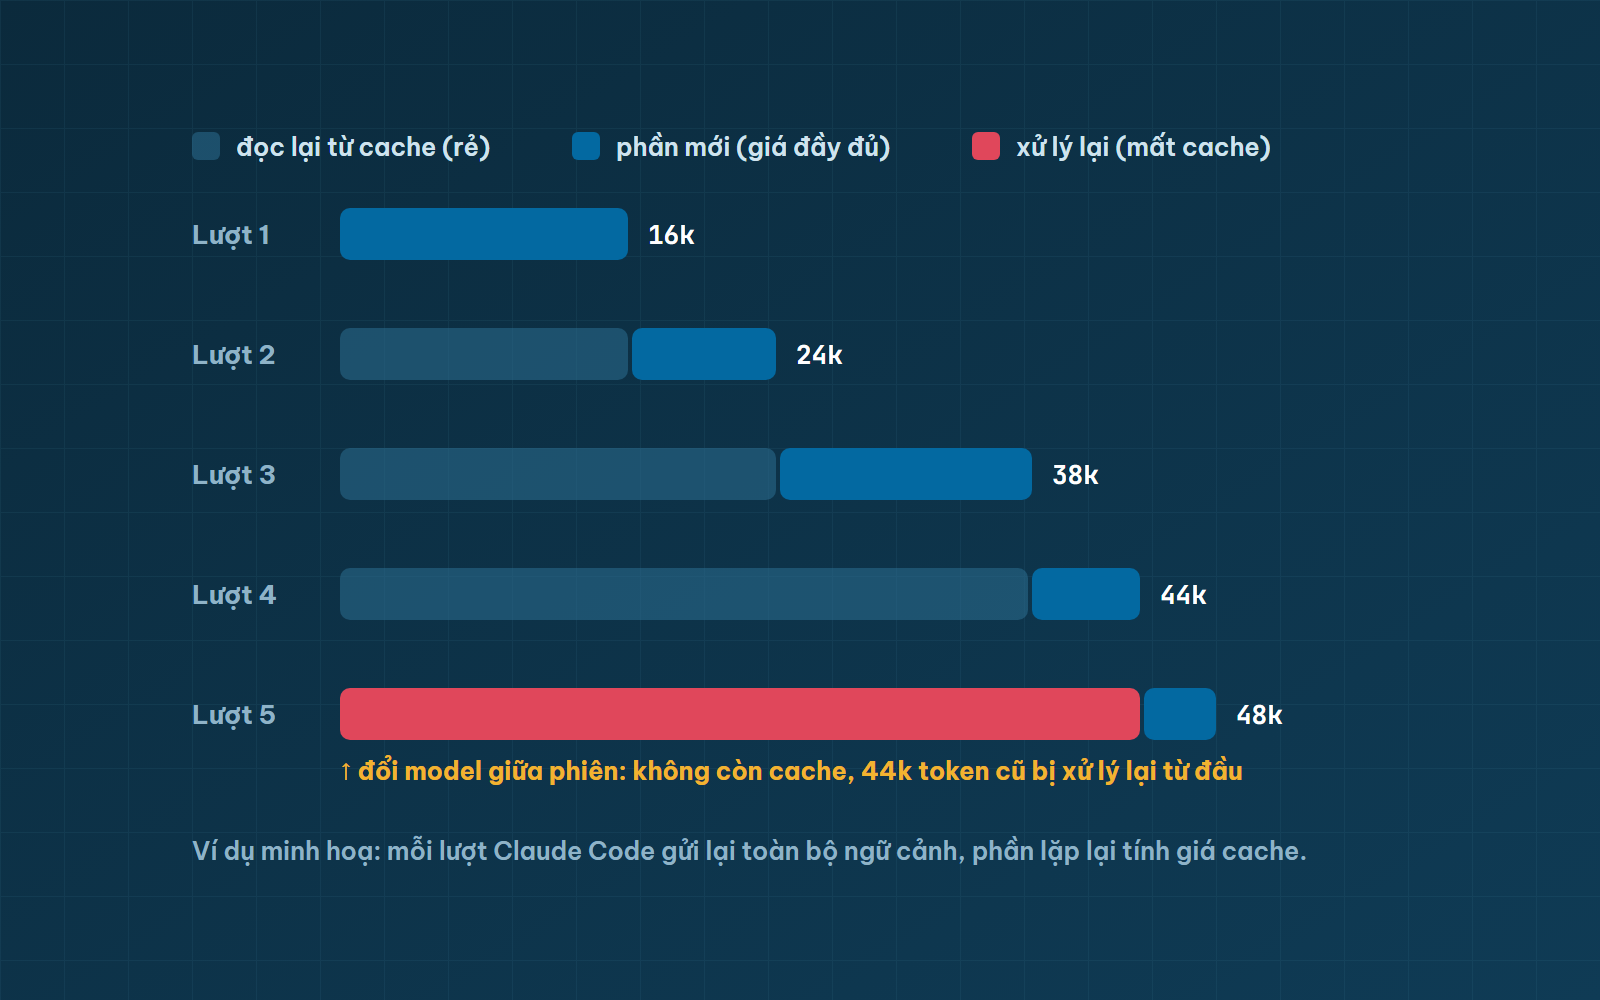
Cache có thời hạn (TTL). Phiên chính có TTL 1 giờ với gói subscription (Pro, Max, Team, Enterprise) còn trong hạn mức, và 5 phút mặc định khi dùng usage credits, API key hoặc cloud provider. Subagent (phiên Claude phụ, xem Cách 7) có TTL 5 phút. Mỗi request trúng cache làm mới đồng hồ, nhưng nghỉ lâu hơn TTL thì lượt đầu tiên khi quay lại phải xử lý lại toàn bộ.
Theo bảng giá API của Anthropic, ghi cache 5 phút bằng 1,25 lần giá input, ghi cache 1 giờ bằng 2 lần, đọc cache bằng 0,1 lần. Riêng Opus 5.5 và Sonnet 5.5, đọc cache chỉ bằng 0,05 lần, tức 5% giá input.
| USD / 1 triệu token | Opus 5.5 | Sonnet 5.5 | Haiku 5.5 (prompt ≤ 100k token) |
|---|---|---|---|
| Input | 4 | 2 | 0,10 |
| Ghi cache 5 phút | 5 | 2,50 | 0,125 |
| Ghi cache 1 giờ | 8 | 4 | 0,20 |
| Đọc cache | 0,20 | 0,10 | 0,01 |
| Output (gồm thinking) | 20 | 10 | 0,50 |
Thử tính với một phiên dùng Sonnet 5.5 đã có 150.000 token ngữ cảnh, hỏi thêm một câu. Cache còn hạn thì đọc lại 150.000 token tốn $0,015. Cache đã hết hạn và phải ghi lại với TTL 5 phút thì cùng phần đó tốn $0,375, gấp 25 lần; ghi lại với TTL 1 giờ tốn $0,60, gấp 40 lần. Trong khi đó, câu trả lời dài 2.000 token output chỉ tốn $0,02.
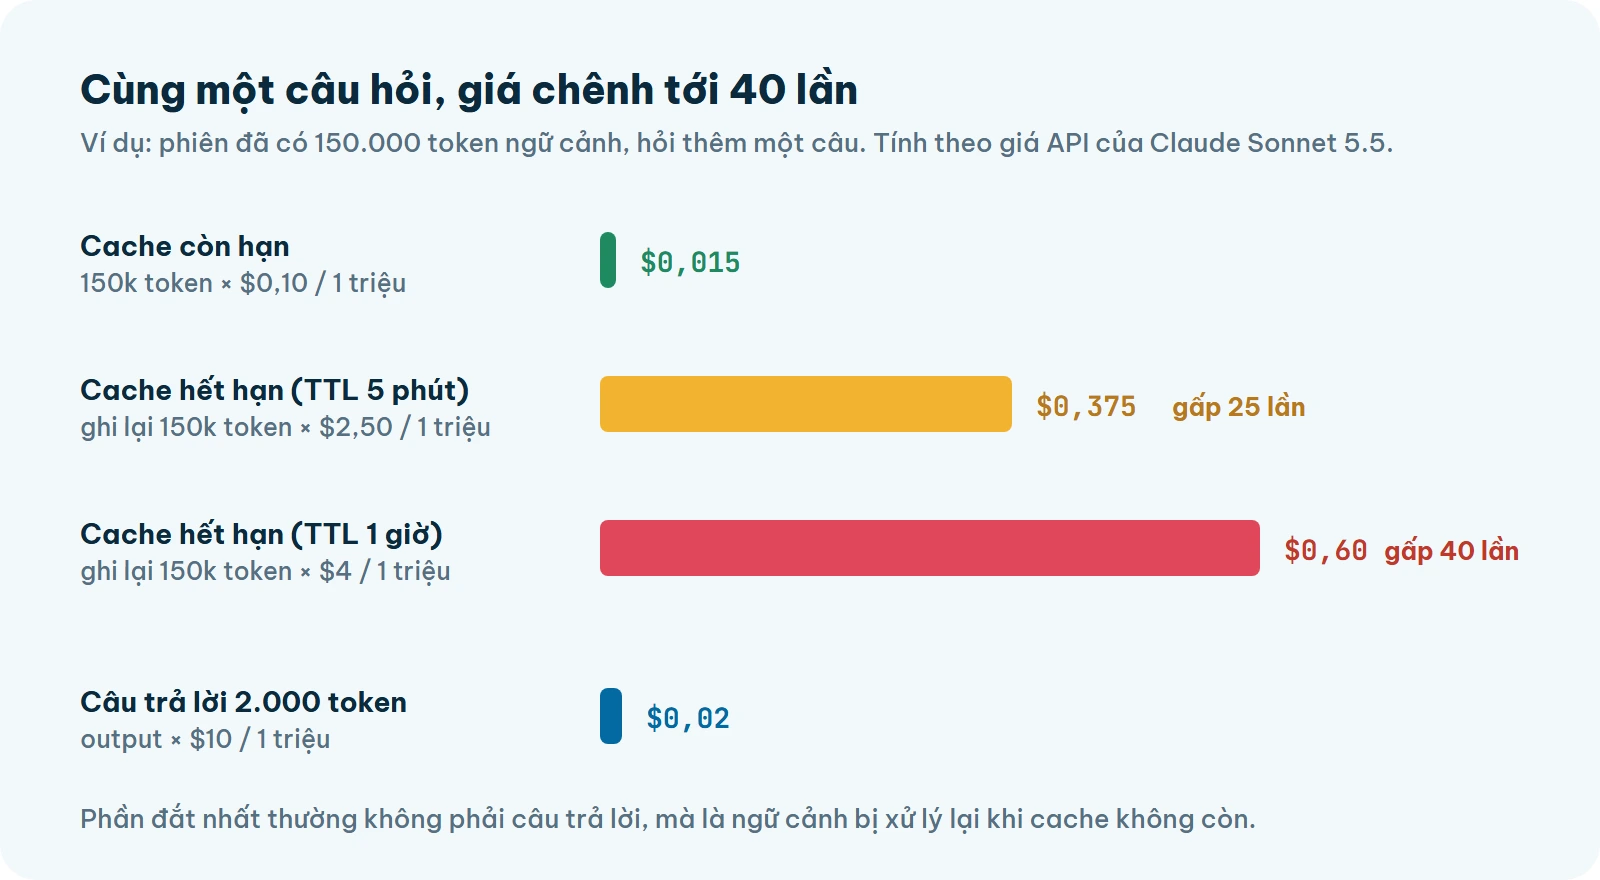
Nói cách khác, khoản đắt nhất ở đây là lần xử lý lại ngữ cảnh, không phải câu trả lời. TTL đổi được bằng setting promptCacheTtl (5m hoặc 1h). TTL 1 giờ làm phần ghi cache mỗi lượt đắt hơn, 2 lần thay vì 1,25 lần giá input. Theo mình, nó chỉ đáng khi anh em hay rời máy quá 5 phút nhưng dưới một giờ giữa các lượt.
Các con số trong bài là giá API. Với gói subscription, mình chưa thấy tài liệu nêu cách quy token ra hạn mức, nhưng cơ chế ngữ cảnh và cache vẫn như trên.
Cách 1: đo trước khi cắt, bằng /usage và /context
Lệnh /usage cho biết token đi đâu: khối Session hiển thị token theo từng model, kèm cache read và cache write. Từ Claude Code v2.1.251, dòng Prompt cache (main) còn cho biết tỷ lệ token đọc từ cache, số lần trượt cache (miss) và cache còn ấm (còn hạn) hay không. Đây là một dòng ví dụ trong tài liệu chi phí:
claude-sonnet-4-6: 1.2k input, 5.3k output, 940.0k cache read, 50.0k cache write ($0.55)Phần cache read (940.000 token) lớn hơn input mới (1.200 token) hàng trăm lần. Lệnh /context cho biết cái gì đang chiếm ngữ cảnh; dòng trạng thái (status line) có thể cấu hình để hiện mức dùng ngữ cảnh liên tục.
Mốc so sánh từ tài liệu chi phí: ở doanh nghiệp, mỗi developer tốn trung bình khoảng $13 mỗi ngày làm việc ($150–250 mỗi tháng), và 90% người dùng dưới $30 mỗi ngày. Khi chi phí API tăng bất thường, hai nguyên nhân hay gặp là để Opus làm model mặc định và để phiên dài không clear.
Cách 2: Sonnet cho phần lớn việc, Opus cho quyết định khó, chọn ngay đầu phiên
Theo tài liệu chi phí, Sonnet làm tốt phần lớn việc code và rẻ hơn Opus; ở bảng trên, Sonnet 5.5 bằng đúng một nửa giá Opus 5.5 ở mọi loại token. Opus nên để cho quyết định kiến trúc phức tạp hoặc suy luận nhiều bước. Đổi bằng /model, đặt mặc định trong /config; subagent làm việc đơn giản thì khai báo model: haiku.
Thinking tính theo giá output, với Sonnet 5.5 là $10 mỗi triệu token, gấp 100 lần giá đọc cache. Việc đơn giản thì hạ effort bằng /effort.
Thời điểm đổi cũng quan trọng. Mỗi model có cache riêng, nên /model giữa phiên buộc lượt kế tiếp xử lý lại toàn bộ ngữ cảnh. Đổi effort thì giữ cache với Opus 5.5, Sonnet 5.5, Haiku 5.5 và Fable 5.1 qua API key hoặc subscription, nhưng mất cache trên một số model khác. Lời khuyên chính thức là chọn cả hai ngay đầu phiên.
Cách 3: tránh các thao tác làm mất cache giữa phiên
Mất cache không gây lỗi, chỉ làm lượt kế tiếp chậm và tốn hơn một lần, nhưng lần đó có thể đắt gấp 25–40 lần như ví dụ trên. Theo tài liệu prompt caching, các thao tác làm mất cache gồm đổi model, bật fast mode lần đầu trong phiên, /compact, và dồn quá nhiều ảnh hoặc PDF vào phiên. Nâng cấp Claude Code rồi khởi động lại cũng vậy. Với MCP server (máy chủ cung cấp thêm công cụ cho Claude), kể cả MCP server đi kèm plugin, việc thêm bớt chỉ làm mất cache khi tính năng tool search không hoạt động, mà tool search mặc định bật.
Ngược lại, sửa file trong repo, đổi permission mode, gọi skill (bộ hướng dẫn đóng gói riêng) hay slash command, /rewind, chạy subagent, đổi output style và /recap đều giữ cache. Sửa CLAUDE.md giữa phiên cũng giữ cache, nhưng nội dung mới chỉ có hiệu lực sau /clear, /compact hoặc khởi động lại.
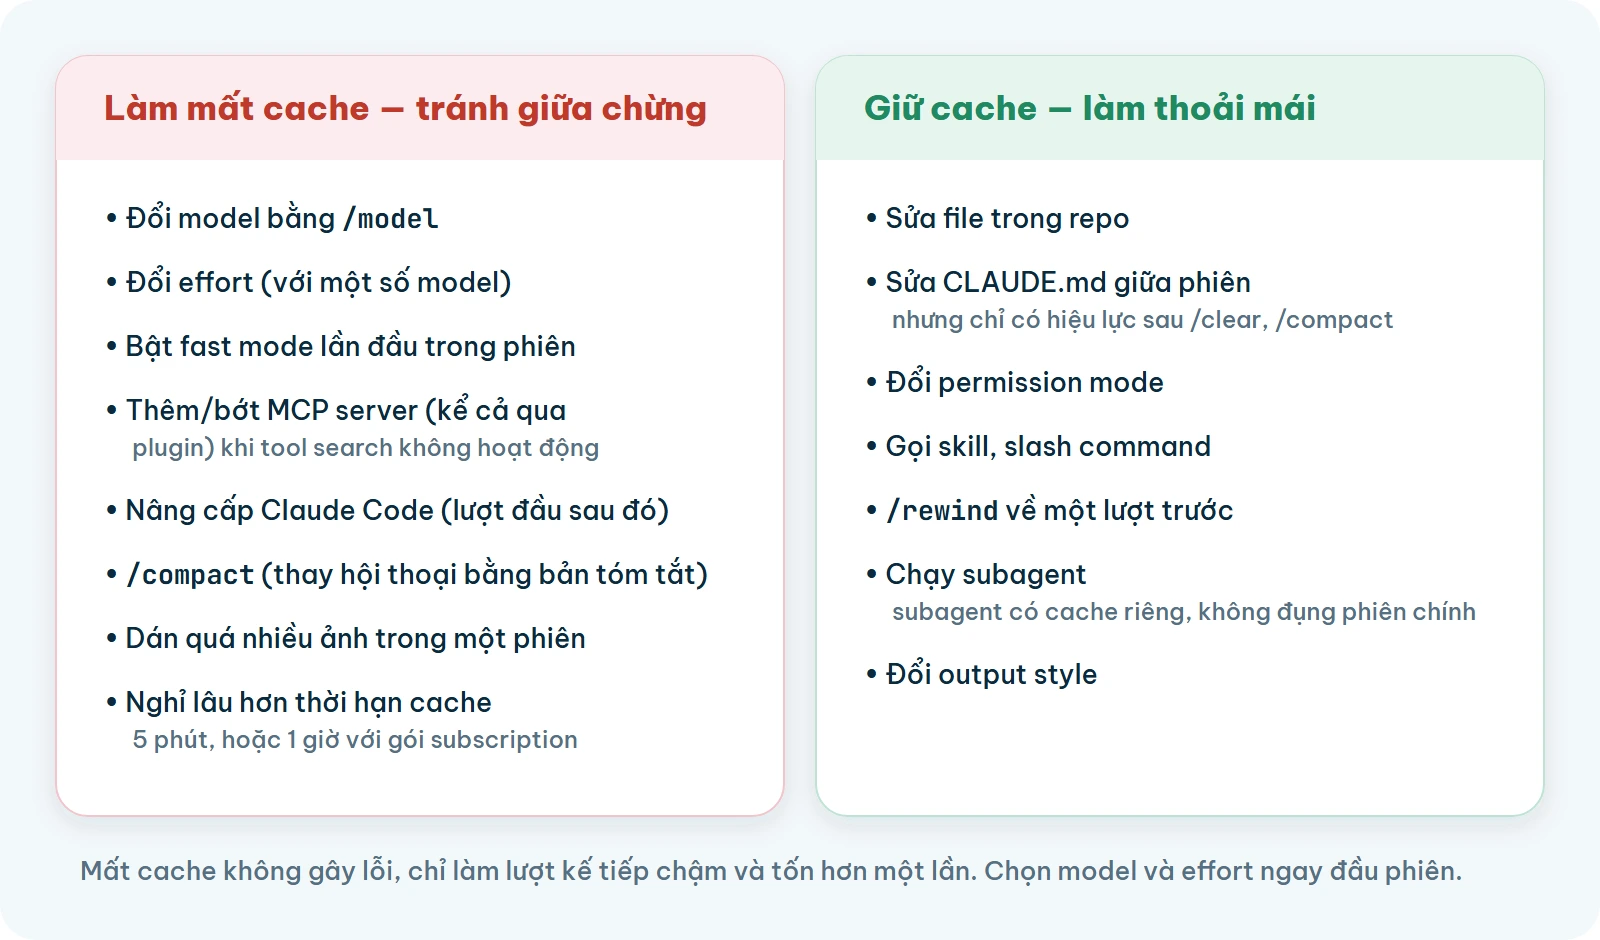
Hệ quả thực tế: thay đổi nào làm mất cache thì dồn về đầu phiên hoặc ngay sau /clear, lúc ngữ cảnh còn nhỏ nên xử lý lại cũng rẻ.
Cách 4: /clear giữa các việc, /compact ở điểm dừng, /rewind khi sai hướng
Theo tài liệu chi phí, ngữ cảnh của việc cũ làm tốn token ở mọi tin nhắn sau, nên chuyển sang việc không liên quan thì /clear, lệnh này không tốn gì. Trước đó đặt tên phiên bằng /rename để sau này mở lại bằng /resume. Tài liệu best practices thêm một mốc: sửa hướng hơn hai lần cho cùng một vấn đề mà vẫn sai thì /clear và viết lại yêu cầu tốt hơn.
Việc đang dở và cần giữ ý chính thì dùng /compact, có thể kèm hướng dẫn như /compact Focus on code samples and API usage hoặc ghi sẵn hướng dẫn trong CLAUDE.md. Lệnh này gửi một request đọc toàn bộ hội thoại để tóm tắt: rẻ khi cache còn hạn, đắt khi vừa nghỉ quá TTL. Vì vậy tài liệu khuyên compact ở điểm dừng tự nhiên, thay vì để Claude Code tự compact giữa chừng (auto-compact).
Vừa đi sai hướng và muốn bỏ hẳn đoạn đó thì dùng /rewind (Esc Esc) thay vì /compact. Rewind quay về một prefix đã có trong cache nên gần như không tốn thêm.
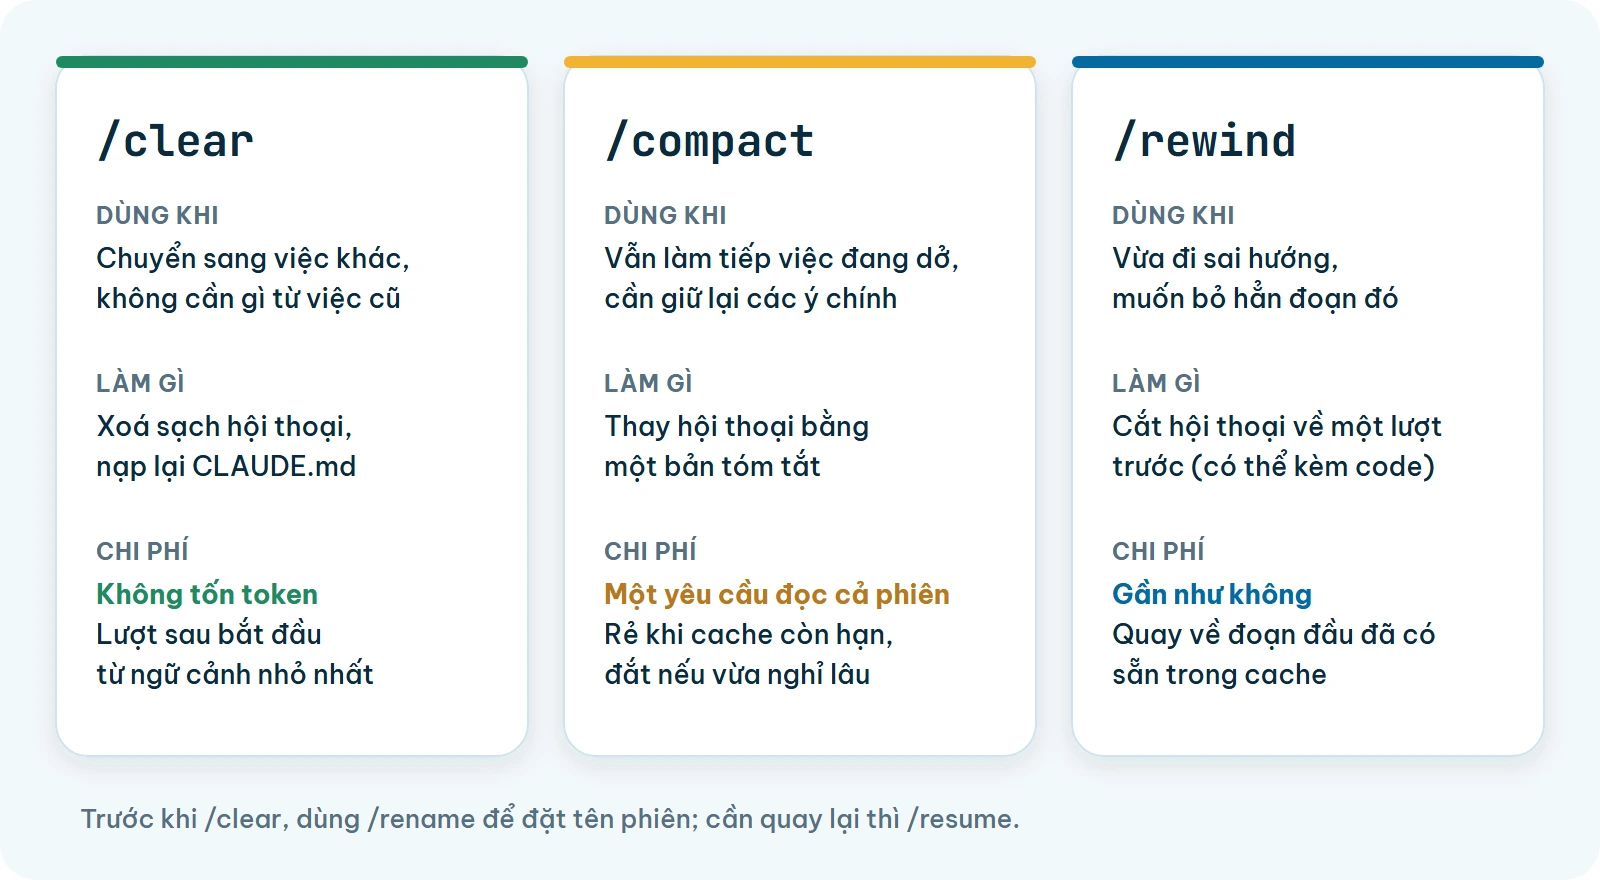
Theo mình, nếu vừa nghỉ quá TTL và việc cũ đã xong thì nên /clear thay vì /compact, vì compact lúc đó xử lý lại cả phiên chỉ để tạo bản tóm tắt.
Cách 5: CLAUDE.md và MCP có mặt ở mọi lượt, nên giữ chúng gọn
CLAUDE.md và định nghĩa công cụ nằm ở đầu request, nên có mặt ở mọi lượt của mọi phiên. Tài liệu chi phí và tài liệu memory của Claude Code khuyên giữ CLAUDE.md dưới 200 dòng. Hướng dẫn chỉ dùng cho một loại việc thì chuyển sang skill, vì skill chỉ nạp khi được gọi. Tách ra file khác rồi import bằng @ không giảm chi phí, vì file import cũng nạp lúc khởi động.
Với MCP server, định nghĩa công cụ mặc định được hoãn, chỉ tên công cụ vào ngữ cảnh cho tới khi dùng. Tài liệu vẫn khuyên ưu tiên CLI như gh, aws, gcloud, sentry-cli vì chúng không thêm danh sách công cụ nào. Server nào không dùng thì tắt trong /mcp.
Cách 6: lọc output bằng hook trước khi nó vào ngữ cảnh
Output lệnh, một khi vào hội thoại, sẽ đi theo mọi request sau đó. Cách chặn từ đầu là dùng hook, tức lệnh do người dùng cấu hình để Claude Code tự chạy; loại PreToolUse chạy trước khi Claude dùng công cụ. Tài liệu chi phí đưa ví dụ: thay vì để Claude đọc file log 10.000 dòng, hook grep ERROR và chỉ trả về dòng khớp, từ hàng chục nghìn token xuống vài trăm.
Ví dụ hook PreToolUse trong tài liệu nhắm vào lệnh test: khi lệnh bắt đầu bằng npm test, pytest hoặc go test, hook viết lại lệnh thành:
# Hook PreToolUse trong tài liệu chi phí của Claude Code: lệnh test gốc ($cmd) được viết lại thành
"$cmd 2>&1 | grep -A 5 -E '(FAIL|ERROR|error:)' | head -100"
Lệnh mới gộp stderr vào stdout, chỉ giữ dòng có FAIL, ERROR hoặc error: kèm 5 dòng sau đó, và dừng ở 100 dòng. Claude vẫn thấy các dòng lỗi mà không phải mang theo những dòng test đã qua ở mọi lượt sau.
Cách 7: việc đọc nhiều thì giao cho subagent, phiên chính chỉ nhận báo cáo
Subagent là một phiên Claude phụ có ngữ cảnh riêng, làm xong thì gửi kết quả về phiên chính. Tài liệu chi phí khuyên giao cho subagent các việc nhiều output như chạy test, đọc tài liệu, xử lý log, để chỉ bản tóm tắt quay về. Chạy subagent không làm mất cache phiên chính. Subagent vẫn tốn token, tính vào usage, nhưng có thể dùng model nhỏ hơn.
Một ví dụ thật, ngày 14/10/2026: khi viết bộ quy tắc văn phong cho chính blog này, mình cho 4 subagent đọc 20 bài viết, tổng khoảng 28.000 chữ. Claude Code báo các subagent dùng lần lượt 121.240, 76.937, 82.508 và 97.337 token, tổng khoảng 378.000 token. Mỗi subagent chỉ gửi về phiên chính một báo cáo khoảng 1.000–1.500 chữ.
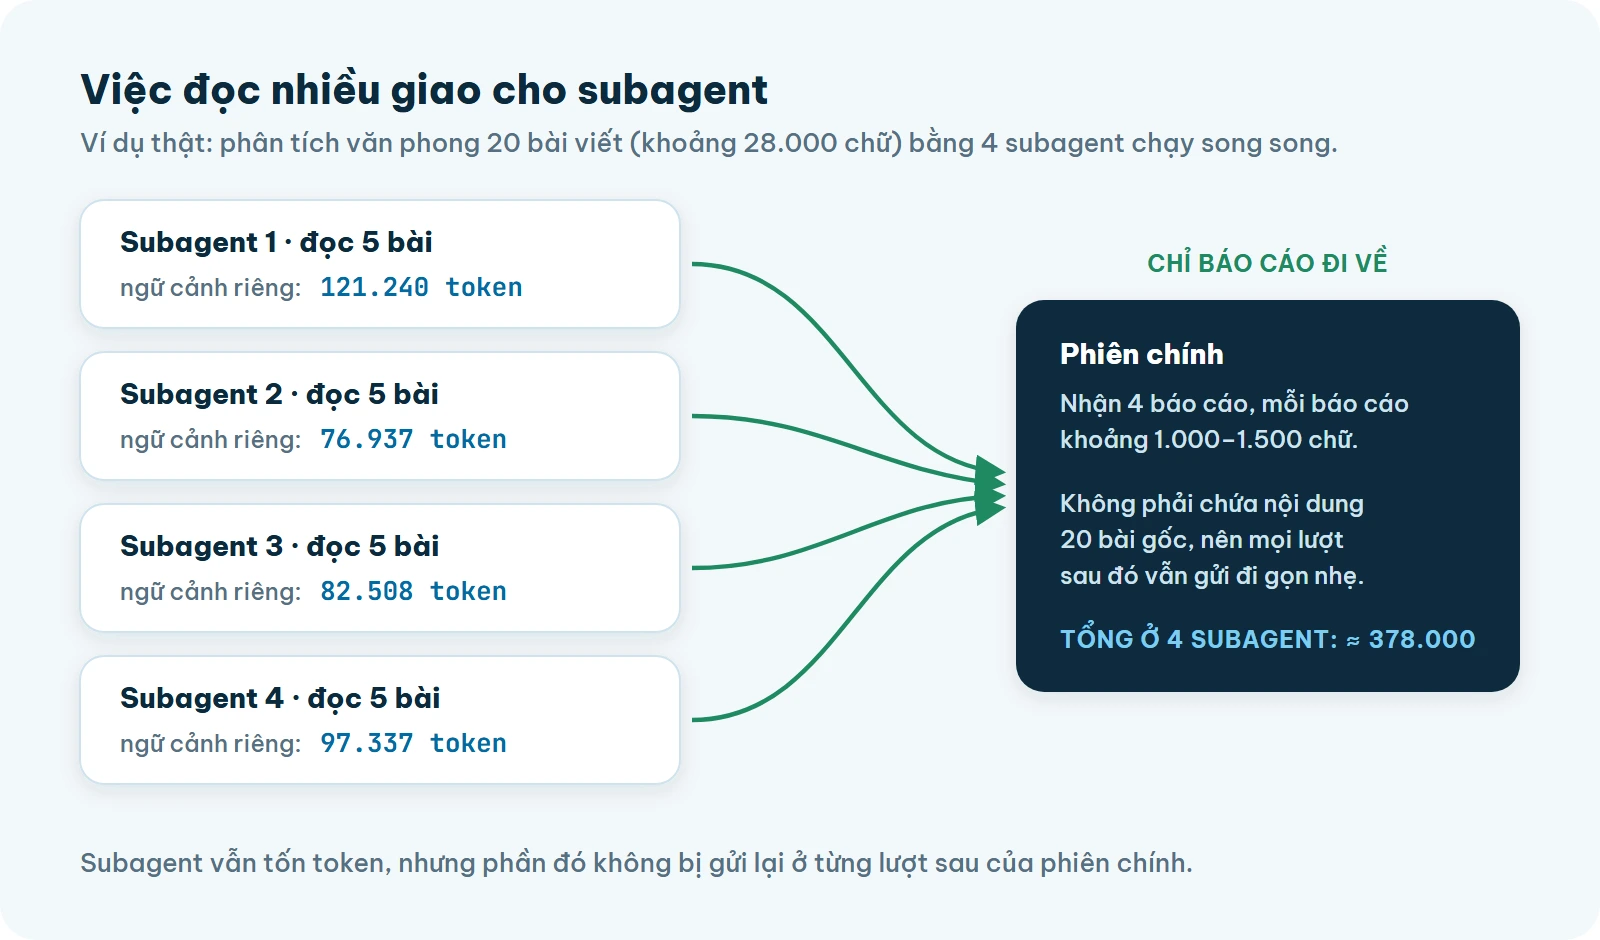
Nếu đọc thẳng trong phiên chính, nội dung 20 bài sẽ nằm lại trong hội thoại và đi theo mọi lượt sau; nhờ subagent, phiên chính chỉ mang theo 4 bản báo cáo. Lưu ý ngược chiều: agent teams (nhiều teammate cùng làm một việc) tốn khoảng 7 lần token so với phiên thường, nên giữ nhóm nhỏ. Con số này áp dụng khi teammate chạy plan mode (chế độ lên kế hoạch trước khi sửa code).
Cách 8: yêu cầu càng cụ thể, Claude càng ít phải đọc file
Mỗi file Claude đọc là thêm một khối nội dung vào hội thoại. Tài liệu best practices so sánh: "improve this codebase" khiến Claude quét rộng, còn "add input validation to the login function in auth.ts" cho phép làm với ít lần đọc file. Với ngôn ngữ có kiểu, plugin code intelligence cho phép "go to definition" thay vì grep rồi đọc nhiều file.
Với việc lớn, tài liệu khuyên vào plan mode (Shift+Tab) trước khi sửa, bấm Esc để dừng ngay khi sai hướng và dùng /rewind để quay lại. Nên cho Claude tiêu chí kiểm tra như test hoặc ảnh chụp để nó tự bắt lỗi, làm từng file và kiểm từng bước. Đi sai hướng càng lâu, đoạn hội thoại thừa bị gửi lại ở mọi lượt sau càng dài. Phần chia nhỏ việc và plan mode mình đã viết kỹ hơn trong bài Vibe coding với Claude Code: 9 nguyên tắc rút ra từ một dự án thật.
Nói gọn lại: ngữ cảnh nhỏ, cache còn hạn, output đã lọc
Checklist cho mỗi phiên làm việc
- Chọn model và effort ngay đầu phiên: Sonnet cho việc thường, Opus cho quyết định kiến trúc phức tạp.
- Chuyển sang việc không liên quan:
/renamerồi/clear. Sửa hướng hơn hai lần vẫn sai:/clearvà viết lại yêu cầu. Vừa đi sai hướng:/rewind. - Sắp rời máy lâu hơn TTL (5 phút mặc định với API key, 1 giờ với gói subscription): dừng ở điểm tự nhiên,
/compactkhi cache còn hạn hoặc/clear. - Đổi model, bật fast mode, bật tắt plugin: làm ở đầu phiên.
- CLAUDE.md dưới 200 dòng, hướng dẫn chuyên biệt chuyển sang skill, MCP server không dùng thì tắt trong
/mcp. - Lệnh có output dài như test, log: lọc bằng hook hoặc giao cho subagent.
- Xem
/usageđịnh kỳ: tỷ lệ đọc cache và số lần miss.
Khoản tốn nhất khi code với Claude Code thường không phải câu trả lời, mà là ngữ cảnh bị gửi lại ở mỗi lượt và bị xử lý lại khi cache mất. Theo mình, giữ ngữ cảnh nhỏ, giữ cache còn hạn và lọc output là ba việc nên làm trước, và không việc nào bắt Claude làm ít đi.
Anh em đang mất nhiều token nhất ở bước nào: đọc file, chạy test hay quay lại sau giờ nghỉ?
Bình luận (0)
Chưa có bình luận nào. Mở hàng nhé!